Сентябрь в mClouds: работаем с ИИ на практике

Автор: Александр
Опубликовано: 06 октября, 2026
Привет! Первый месяц осени мы посвятили ИИ: расширили выбор GPU-конфигураций для аренды, обновили сервис резервного копирования и подготовили материалы для работы с ИИ — от выбора видеопамяти до запуска помощника по документам компании.
Запустили новый тариф: две NVIDIA L4 в одной машине
Если одной L4 уже мало, а NVIDIA L40S — это «слишком сложно и дорого», у нас появилось то, что нужно. Конфигурация с двумя NVIDIA L4 в одной виртуальной машине дает 48 ГБ видеопамяти для ваших проектов по доступной стоимости.
В составе:
- 2 × NVIDIA L4 по 24 ГБ
- 16 vCPU на высокочастотных процессорах AMD EPYC 9555
- 64 ГБ DDR5
- 300 ГБ NVMe
Конфигурация подойдет для запуска LLM, ИИ-помощников, экспериментов с дообучением моделей, генерации картинок и обработки видео.
Подробнее посмотреть тарифы на GPU-серверы.
Обновили резервное копирование BaaS до 13-й версии Veeam
Самое главное, что изменилось — безопасность. В последней версии были устранены значимые уязвимости. Также добавились ИИ-анализ подозрительной активности, двойное подтверждение критичных действий и поддержка единого входа.
Ускорилось восстановление, расширилась поддержка CDP для физических и виртуальных Linux- и Windows-нагрузок, что позволяет защищать данные с минимальной точкой восстановления.
Самое новое - сначала в нашем канале Телеграм
В сентябре добавили несколько полезных материалов, которые помогут настроить CrowdSec, использовать ИИ для работы с корпоративной базой знаний. А еще разобрались, какие форматы используют компании и дата-центры, чтобы расширить память.
Безопасность. Показали, как настроить CrowdSec для защиты сервера, чтобы вовремя обнаруживать подозрительную активность, блокировать перебор паролей SSH и проверять веб-запросы.
Читать: про настройку CrowdSec на Linux
ИИ. Объяснили, как подключить документы компании к ИИ-помощнику. Разобрались, сколько видеопамяти понадобится языковой модели с учетом контекста и одновременных запросов.
Читать: про RAG, про видеопамять
Технологии. Обсудили NVIDIA RTX PRO 5500 Blackwell, расширение серверной памяти через CXL и применение LPDDR5X в дата-центрах.
Читать: про GPU, про CXL, про LPDDR5X
Новости и свежие материалы mClouds быстрее всего появляются в Телеграме. Подписывайтесь на наш канал.
Опубликовали статьи на Хабре
В сентябре добавили две статьи: рассказали о технологии CXL для расширения памяти сервера и разобрались, зачем дата-центры устанавливают «ноутбучную» память.
Больше RAM через PCIe: как работает CXL
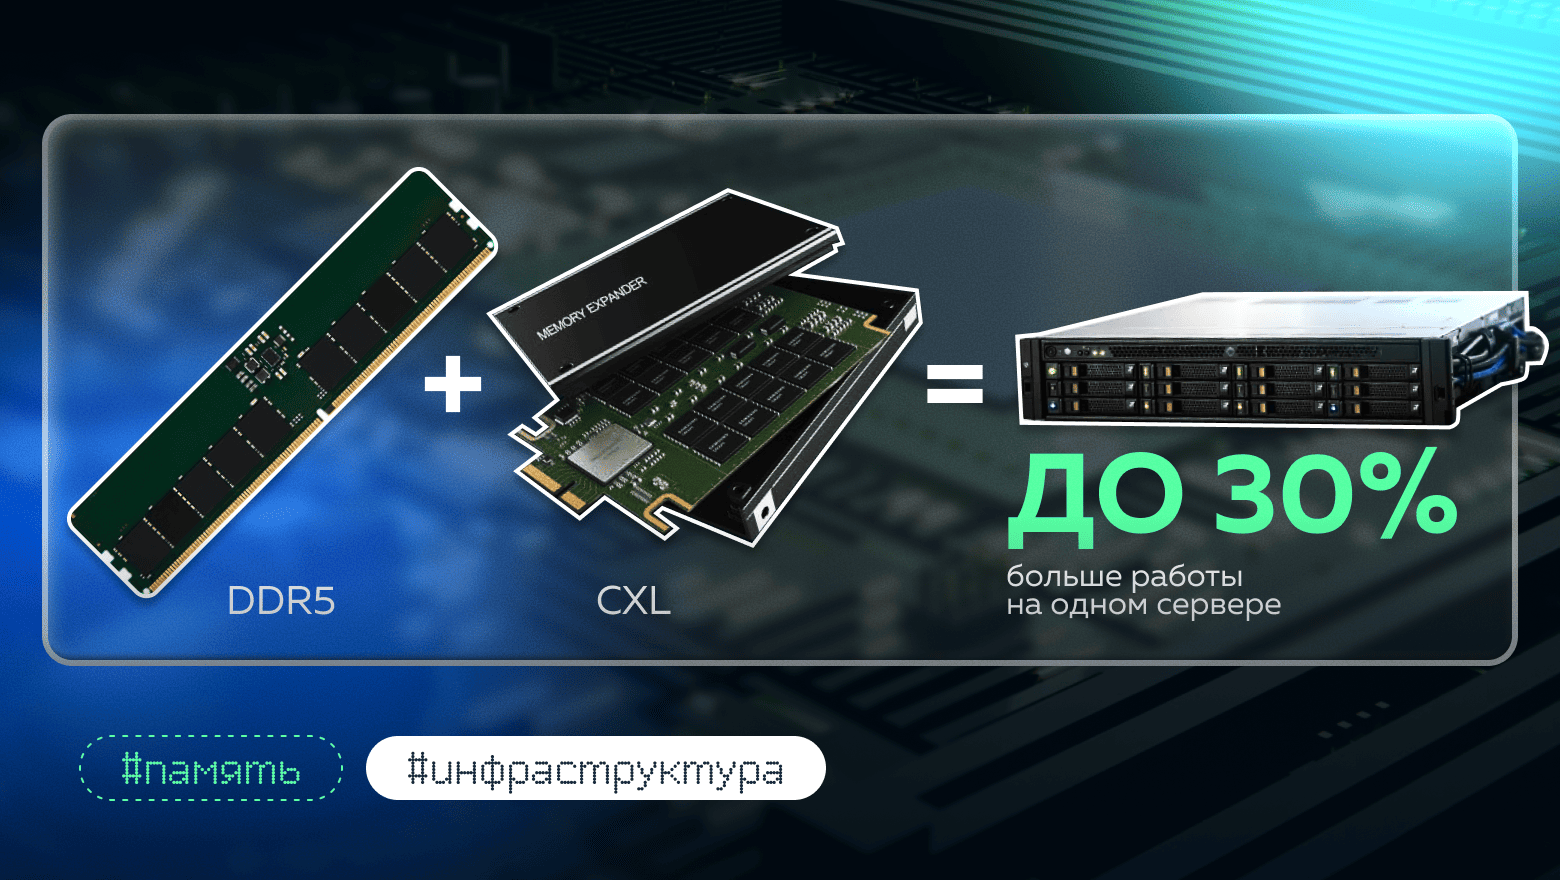
Бывает, процессор еще справляется, а оперативной памяти уже не хватает. Разобрали, как технология CXL расширяет серверную память, можно ли повторно использовать старые модули DDR4 и какие ограничения есть по скорости и совместимости.
«Ноутбучная» память приходит в серверы
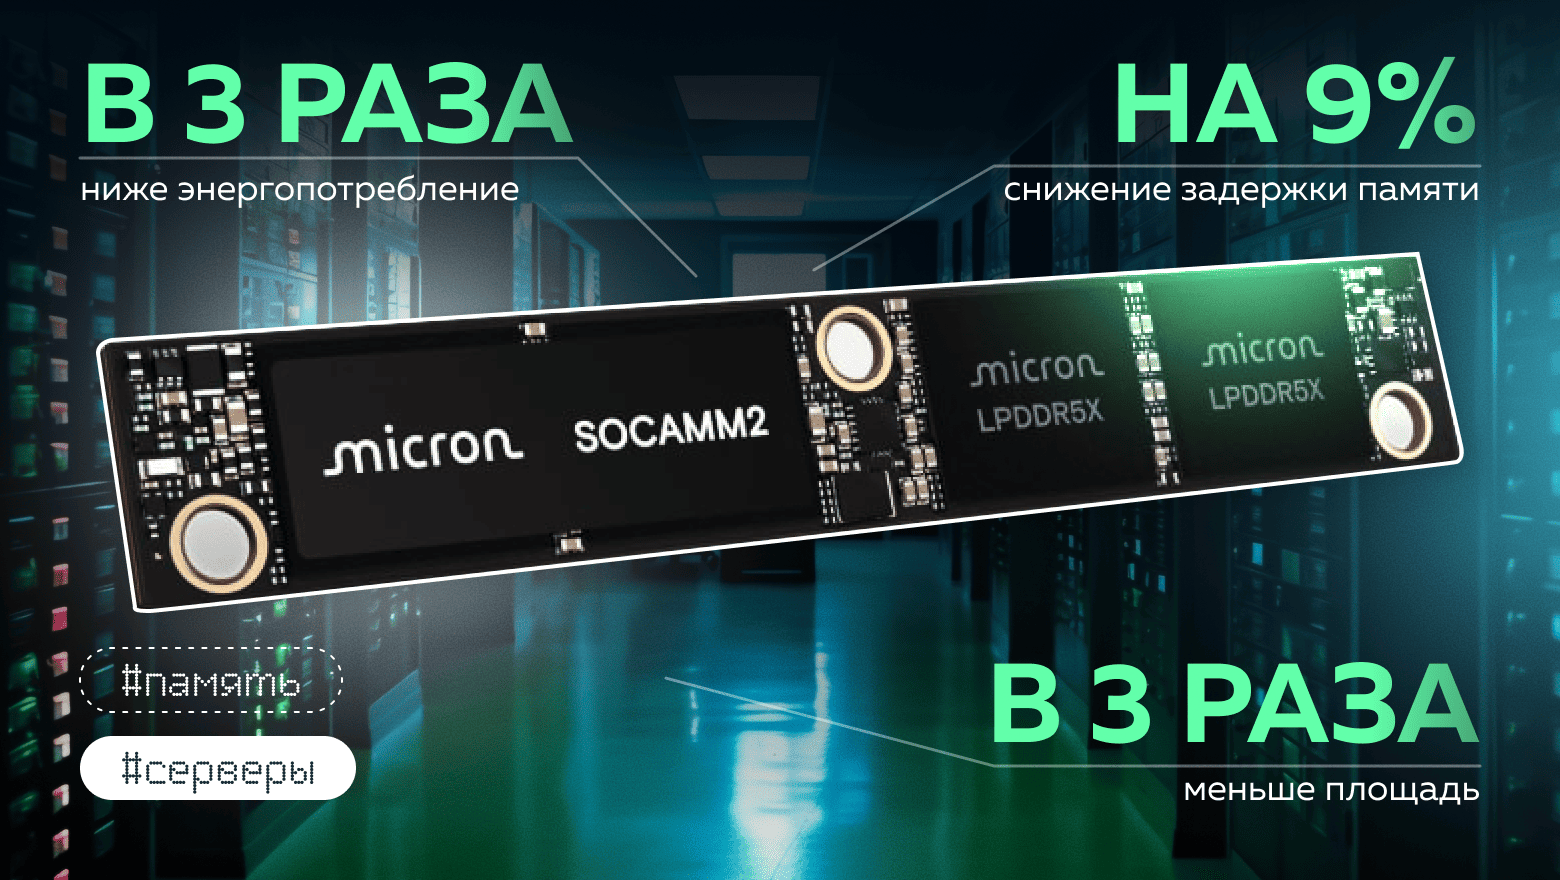
Рассказали, зачем дата-центрам LPDDR5X и съемные модули SOCAMM2. Дело в том, что такая память потребляет меньше энергии, и для CPU и GPU остается больше свободной мощности. В статье обсудили устройство нового формата и результаты испытаний в задачах ИИ, веб-сервисах и аналитике.
Рассказали в блоге о объемах VRAM для LLM и запуске RAG системах
Заходите в наш блог — в сентябре там появилось несколько полезных материалов, которые помогут вам в реализации проектов с ИИ.
Как правильно оценить объем VRAM для запуска LLM
Чтобы правильно выбрать GPU для запуска LLM, мало учитывать размер модели. Даже если LLM занимает 14 ГБ, видеокарты на 16 ГБ может не хватить: длинные диалоги и одновременные запросы требуют дополнительной памяти. Объясняем, как оценить реальную нагрузку и не промахнуться с выбором GPU.
Как запустить локальную LLM с RAG-системой на своем сервере
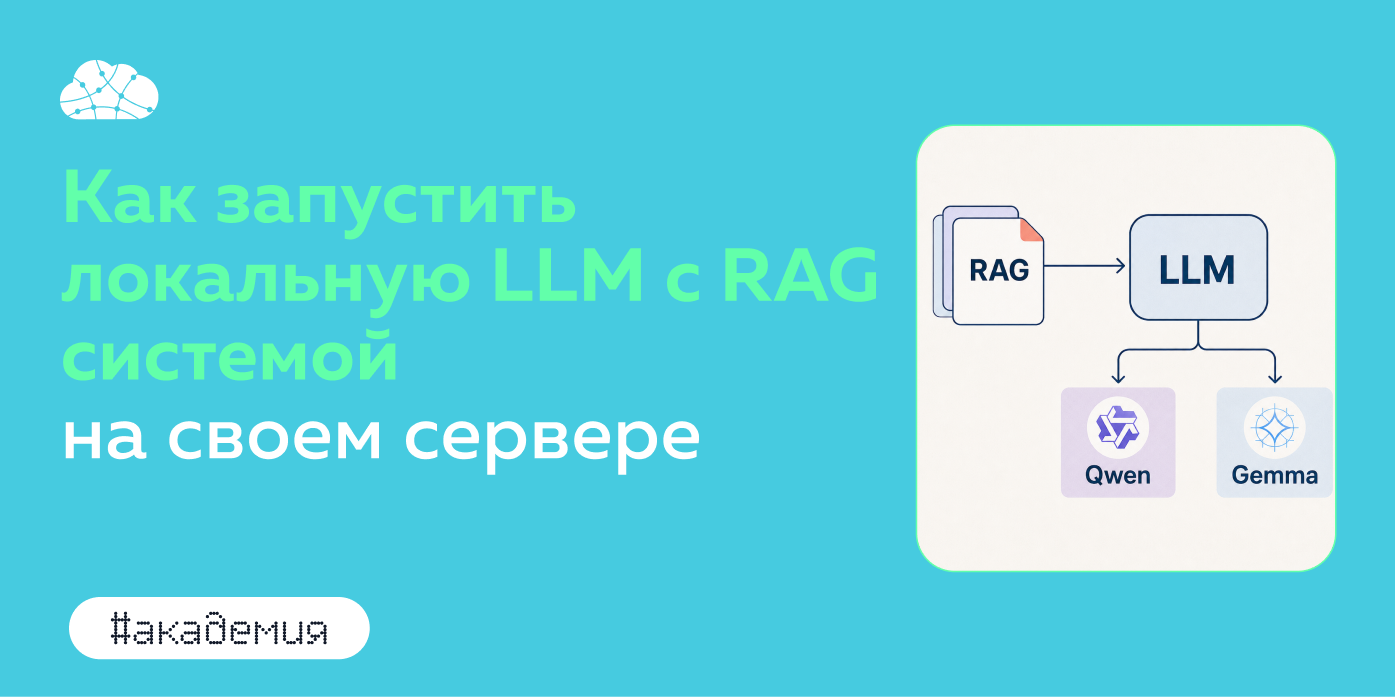
Подготовили пошаговое руководство по запуску LLM с RAG — с поиском ответов на основе вашей базы знаний. Показываем, как развернуть систему на GPU-сервере mClouds, подключить документы и настроить веб-интерфейс. Такой помощник пригодится для поиска по инструкциям, регламентам и внутреннему FAQ.
В этой же статье ⬇️
Qwen или Gemma: сравнили модели на практике
Протестировали Qwen3.5-9B и Gemma 4 E4B на NVIDIA L4 24 ГБ: задали обеим моделям один и тот же вопрос и сравнили ответы на русском языке с подключенной базой знаний и без нее. При анализе результатов учитывали также скорость генерации и расход видеопамяти. Gemma показала около 45 токенов в секунду, Qwen — около 28. Gemma отвечала более кратко и по существу, а Qwen добавляла подробности. Разбираем результаты и объясняем, на что смотреть при выборе модели под свои документы и задачи.
Сохраняйте сайт mClouds в закладки, подписывайтесь на наш блог на Хабре и телеграм-канал — мы регулярно делимся полезными материалами и инструкциями, которые помогут вам быстрее реализовывать проекты, усиливать безопасность и экономить ресурсы. Работаем для вас!
06 октября, 2026
 Июльский дайджест обновлений - добавили больше GPU и обновили 152-ФЗ
Вот что у нас нового в июле: добавили еще больше видеокарт в облаке - NVIDIA L40S и A16, завершили аттестацию всей платформы по 152-ФЗ, попали на карту ИТ-лидеров CNewsMarket и, конечно, продолжили публиковать статьи на Хабре и в нашем блоге. Заходите, чтобы узнать о процессорах EPYC Venice Zen6 и других новинках рынка.
04 августа, 2026 Первый теплый дайджест: обновили GPU-платформу, тарифы и поддержку
В мае у нас было много обновлений, а именно - открыли для заказа диски PCIe Gen 5 уже с видеокартами NVIDIA L4 24 ГБ, добавили Ubuntu 26.04 в доступные образы для IaaS, обновили сайт и улучшили раздел поддержки. Сделали обзор нашей GPU платформы.
05 июня, 2026 Запустили новую облачную GPU-платформу и другие обновления марта
Добавили новый кластер с новейшими процессорами AMD EPYC 9555 с 128 физическими ядрами на узел и рабочей частотой 4,2 ГГц. Еще больше скорости для ваших задач с 1С , нейросетями, работе с VDI и других задач, требующих высокой производительности. А еще добавили пул видеокарт NVIDIA L4 24GB и NVIDIA A16 64GB. Вошли в рейтинг облачных провайдеров резервного копирования и писали интересный контент!
02 апреля, 2026