Как запустить локальную LLM с RAG системой на своем сервере

Автор: Дмитрий
Опубликовано: 27 августа, 2026
В этой статье мы пошагово разберём, как развернуть локальную RAG-систему на своем GPU-сервере, для примера будем использовать наши облачные GPU-серверы с NVIDIA L4 24GB. Для запуска моделей локально, будем использовать vLLM, для работы с базой знаний и запросами — Open WebUI. Заодно проведем тестирование и сравнение на базе LLM моделей Qwen3.5-9B и Gemma 4 E4B по скорости генерации, потреблению видеопамяти и качеству ответов на русском языке.
В результате мы получим систему, которая отвечает на вопросы по загруженным документам, работает через удобный веб-интерфейс и не передаёт ваши данные наружу, работает локально и изолировано, обучена на примере нашего тестового текста. Заодно посмотрим требования к ресурсам, таким как GPU, CPU и оперативная память, основные настройки vLLM и затронем безопасность развернутой RAG системы.
Какие задачи может решить RAG система
Применимость RAG можно разделить на две категории:
Внутренние задачи: Модель может давать ответы на основе документации, такой, как статьи в Wiki, внутренний FAQ, инструкций, регламентов, что позволяет сотрудникам легче искать информацию: вместо множества сервисов или многоуровневой организации корпоративной Wiki, сотрудник задаёт вопрос модели через интуитивно понятный веб интерфейс и получает ответ быстрее, чем с помощью ручного поиска
Задачи для работы с клиентами: Помимо использования Wiki и FAQ, модель может давать первичные ответы клиентам, а далее, эскалировать запрос на ответственного сотрудника, использовать базу запросов клиентов и генерировать ответ на основе предыдущих обращений клиентов
Ожидания от запуска RAG системы
Наша цель: на основе документа, который мы “скормим” моделям, получить качественный ответ на заданный вопрос по нужной теме, с минимумом придуманной моделью информации, с небольшими временными затратами на настройку стека
Желаемый результат работы:
- Модель отвечает в соответствии с предоставленной базой знаний
- Ответ на русском языке
- В ответе нет “выдуманной” информации
- Модель должна занимать 16-20 GB VRAM
- Скорость генерации 20-25 токенов в секунду
RAG используется также для снижения уровня галлюцинаций. Вы можете использовать модель с теми знаниями, которые у неё есть в базе, но когда модели будет не хватать знаний, она будет придумывать информацию и давать некачественный ответ. Использование собственных данных поможет поддерживать актуальность ответов, использовать, например, внутреннюю документацию для получения быстрых ответов
Для RAG нам будут нужны данные - источников может быть несколько: внутренняя WIKI, база запросов от клиентов, общедоступные подборки для подключения данных к вашей модели. В качестве примера мы возьмём инструкцию из нашего портала поддержки, статью по настройке терминального сервера.
В зависимости от целей, будет меняться размер данных, которые модели будут использовать для генерации ответов, поэтому выяснить достаточно ли велика база знаний удобно проверить опытным путём, тестируя модели и конфигурации серверов в облаке.
Для выполнения этих целей нам необходим сервер
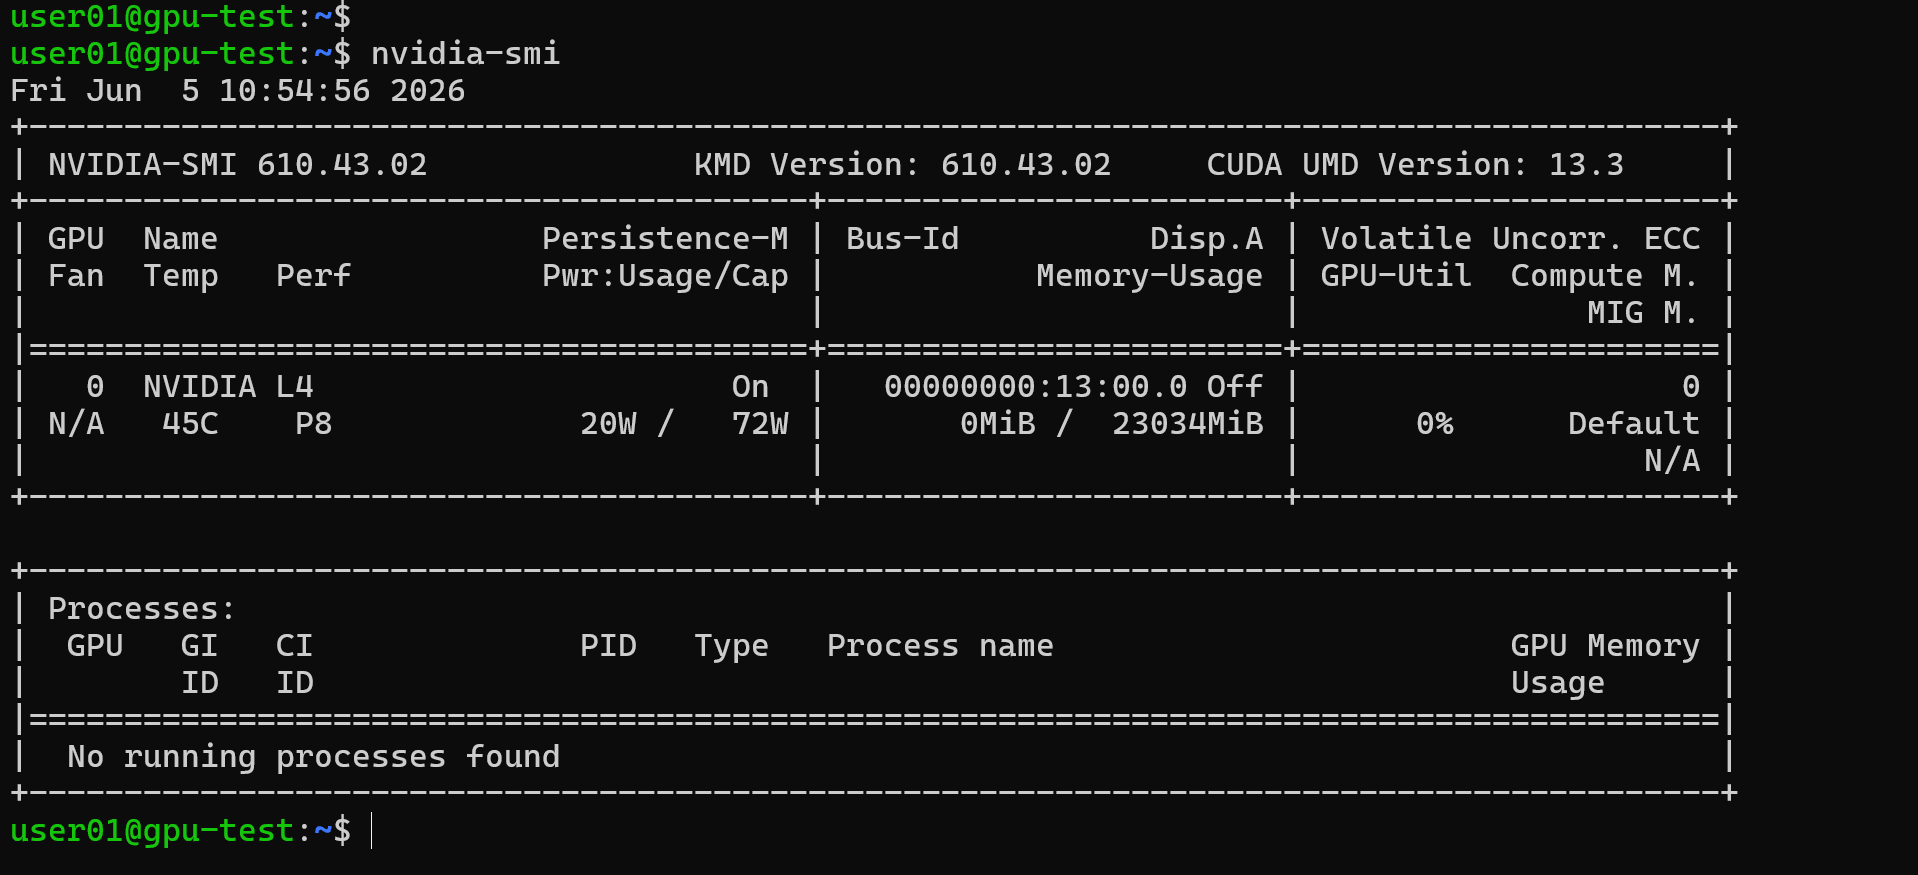
Для работы с LLM в mClouds, в нашем облаке чаще используются серверы с NVIDIA L40S 48GB и NVIDIA L4 24Gb. В примере будем использовать NVIDIA L4 с 24GB VRAM. Стендом для демонстрации будет GPU сервер с параметрами 8 vCPU, 32GB RAM, Nvidia L4 24GB VRAM, используются драйвера Nvidia 610.43.02 и Nvidia CUDA 13.3
Выбор модели для RAG
Процесс выбора наиболее подходящей для вас модели может затянуться на долгое время, так как параметров для выбора - множество.
Мы будем использовать две модели: qwen3.5:9b и gemma4-E4B-it, сравним их
Интересующие нас поля: parameters, context length, vocabulary size
- Parameters - Количество параметров определяет умение модели обучаться и рассуждать
- Context Length - Максимальное количество токенов, которые модель может одновременно обработать
- Vocabulary Size - Количество уникальных токенов модели, чем больше число, тем больше знает модель
|
Модель |
Number of Parameters |
Context Length |
Vocabulary Size |
|
qwen 3.5:9b |
9B |
262,144 |
248,320 |
|
gemma4-E4B-it |
4.5B Effective |
128,000 |
262,000 |
Обе модели подходят под L4 и под RAG. В ходе статьи мы обсудим специфику моделей в работе с базами знаний, а пока перейдём к запуску vllm и Open WebUI.
Требования к серверу для LLM
Сейчас стоит уделить внимание тому, что именно потребляет драгоценную видеопамять. Так или иначе, каждый параметр модели влияет на потребляемую VRAM, так как именно видеокарта работает с вычислениями, характерными для LLM, быстрее всего
Начнём с количества параметров.
Параметры - это числовые значения, которые были сформированы в процессе первичного обучения и в dense моделях, они все используются в обработке каждого входного токена. Эти параметры и составляют большую часть размера модели и загружаются в полном объёме в VRAM и характеристики вашей видеокарты напрямую влияют на скорость обработки токенов с параметрами.
Далее, Key-Value Cache - механизм, который записывает результаты предыдущих вычислений, чтобы ускорить процесс работы модели и удерживать контекст запросов.
Без KV-Cache, при появлении нового запроса, модели пришлось бы заново пересчитывать результаты предыдущих запросов, добавить к ним новый запрос, дать ответ и “забыть” диалог снова.
Context Length - это максимальное количество токенов, которое модель может одновременно учитывать при вычислении следующего токена. То есть, насколько далеко в прошлые запросы и их кэш может смотреть модель. Не занимает VRAM, так как является характеристикой, но плотно связана с видеопамятью, так как увеличение контекста в памяти напрямую влияет на увеличение утилизируемой VRAM.
Механизмы, вроде offloading также присутствуют, чтобы снизить нагрузку на GPU и, например, получить возможность запускать более тяжёлые модели
Работа CPU, RAM и диска в LLM
CPU
Начнём с того, что основная работа приходится не только на видеокарту, её часть в работе - вычислять токены, работать с кэшем и весами - то, на что заточены тензорные ядра, но работа с LLM не состоит только из этих процессов, хоть они и являются его основой.
CPU работает с сетью, с токенизацией и детокенизацией, контроллирует порядок выполнения запросов, управляет памятью, как RAM/Disk при оффлоадинге, так и VRAM, поэтому, если CPU будет не успевать за скоростью работы модели, то, понижение производительности и качества ответов модели для всех пользователей уменьшится. В конфигурации нашего сервера используются 8 ядер процессора AMD Epyc 9555 с базовой частотой ядер 3.2 ГГц, all-core boost 4.2 ГГц и данные процессоры в прекрасно себя показывают в работе с большими языковыми моделями
Диск и RAM
Несмотря на малую пригодность для основных процессов работы LLM, оперативная память также утилизируется: при запуске LLM, так как модель сначала с диска загружается в RAM, а потом в VRAM, также в случае нехватки видеопамяти, часть весов модели, токенов могут размещаться на диске или оперативной памяти, если упрощать, то дисковая подсистема и RAM - могут быть подстраховкой в случае нехватки VRAM. Также мы рекомендуем использовать NVMe диски, для ускорения загрузки данных в память видеокарты.
Установка и запуск vLLM и Open WebUI для RAG
Стартовой точкой будет чистая система Ubuntu 24.04 LTS с установленными драйверами и CUDA Toolkit.
Для RAG мы будем использовать стек vLLM + Open WebUI. Почему не ollama? Потому что ollama - хороший вариант для того, чтобы влиться в работу с моделями, но когда ваш проект увеличивается или, быть может, увеличивается количество пользователей вашей модели, ollama значительно замедляется в работе, так как заточена под удобство использования, а не максимальную эффективность в работе. Поэтому мы будем использовать vLLM - высокопроизводительный и эффективно использующий память движок для инференса и обслуживания больших языковых моделей.
vLLM представляет собой python библиотеку, поэтому для установки вам понадобится Linux и Python: 3.10 - 3.13, в случае Ubuntu 24.04 - Python 3.12
Устанавливать vLLM будем в отдельный venv, чтобы не затронуть системные утилиты, поэтому для начала создаём виртуальное пространство Python с помощью
python3 -m venv “Название окружения”
Подключаемся к пространству с помощью
source “Название окружения”/bin/activate
И устанавливаем библиотеку vllm
pip install vllm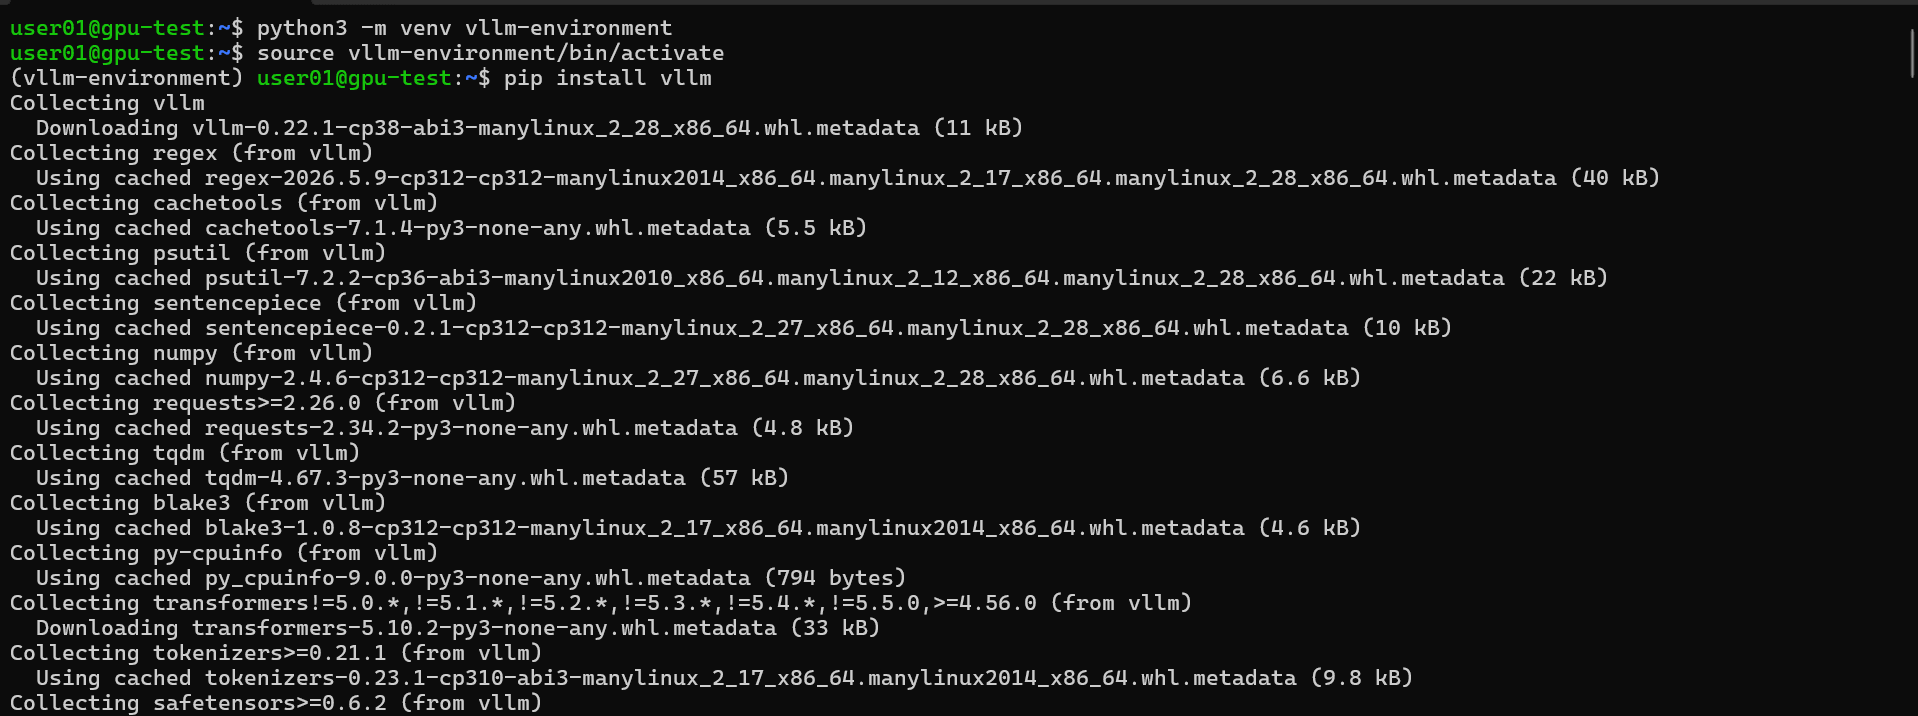
Установка vLLM завершена и теперь можно скачивать необходимую модель и она будет запущена, в нашем случае, будем запускать gemma-4-E4B-it, но перед запуском модели уточним, что для использования open-webui нам необходимо локально запустить совместимый с OpenAI API, чтобы Open WebUI думал, что подключается к серверам OpenAI
Сделать это можно командой
vllm serve google/gemma-4-E4B-it --host <ip-address> --port <port> --gpu-memory-utilization <0-1>
--gpu-memory-utilization - это количество максимально занимаемого места моделью. Свободная видеопамять резервируется под KV-Cache
--max-model-len - максимально доступное контекстное окно в токенах. Чем больше токенов тратится на вопрос, тем меньше токенов потратится на ответ.
Параметр не используется в примере, так как запускаем модель со значением по умолчанию, то есть, с максимально возможным, но данный параметр влияет на то, насколько большой KV-Cache модели нужно выделить.
Строка запуска qwen3.5:9b будет выглядеть следующим образом:
vllm serve qwen3.5-9b --host <ip-address> --port <port> --gpu-memory-utilization <0-1>
Прим. Будьте аккуратны с регистром символов, если вы в команде укажете абсолютно идентичную модель, но в другом регистре, начнётся загрузка “новой” модели.
Запустим команду
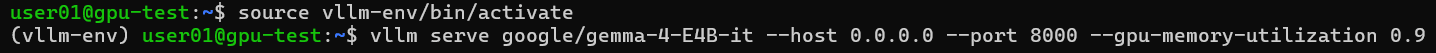
После этого запустится процесс загрузки и запуска модели с указанными параметрами
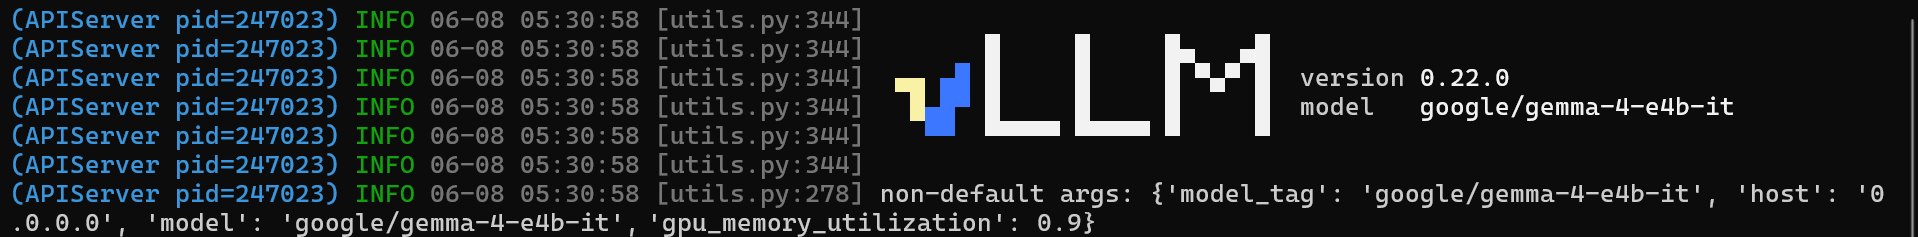
И наконец, когда модель будет запущена, появится соответствующее сообщение

Теперь, запустим Open WebUI в docker командой
docker run -d -p 3000:8080 --add-host=host.docker.internal:host-gateway -v open-webui:/app/backend/data --name open-webui ghcr.io/open-webui/open-webui:mainНа этом, все приготовления закончены и мы можем заходить в Open WebUI, обращаясь к порту 3000
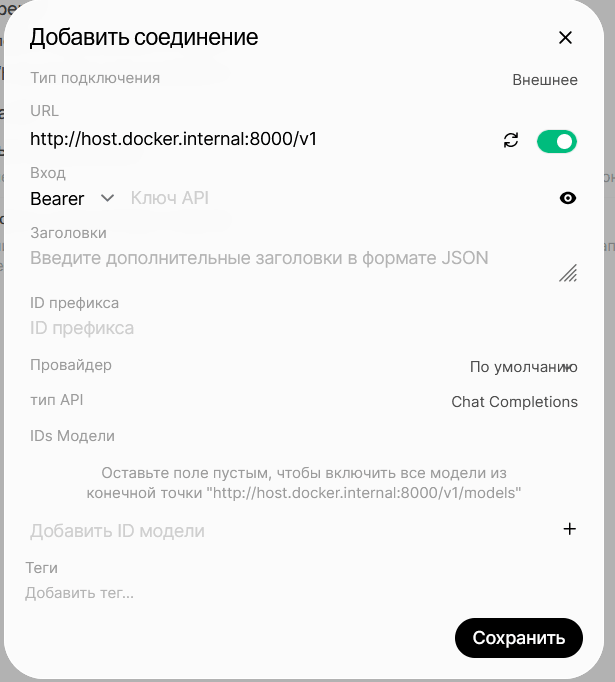
Но для того, чтобы использовать модели нужно сделать некоторые настройки. После создания учётной записи, нажмите на аватар и перейдите в панель администратора, а затем в настройки
Переходите в подключения и добавляйте новое подключение, URL - http://host.docker.internal:8000/v1
API ключ можете оставить любым, Open WebUI требует не пустое поле, однако, в таком случае порт 8000 (порт контейнера) доступен каждому, кто может к нему обратиться, поэтому рекомендуем настроить Firewall и защитить подключения по порту 3000, который используется, чтобы получить доступ к контейнеру.
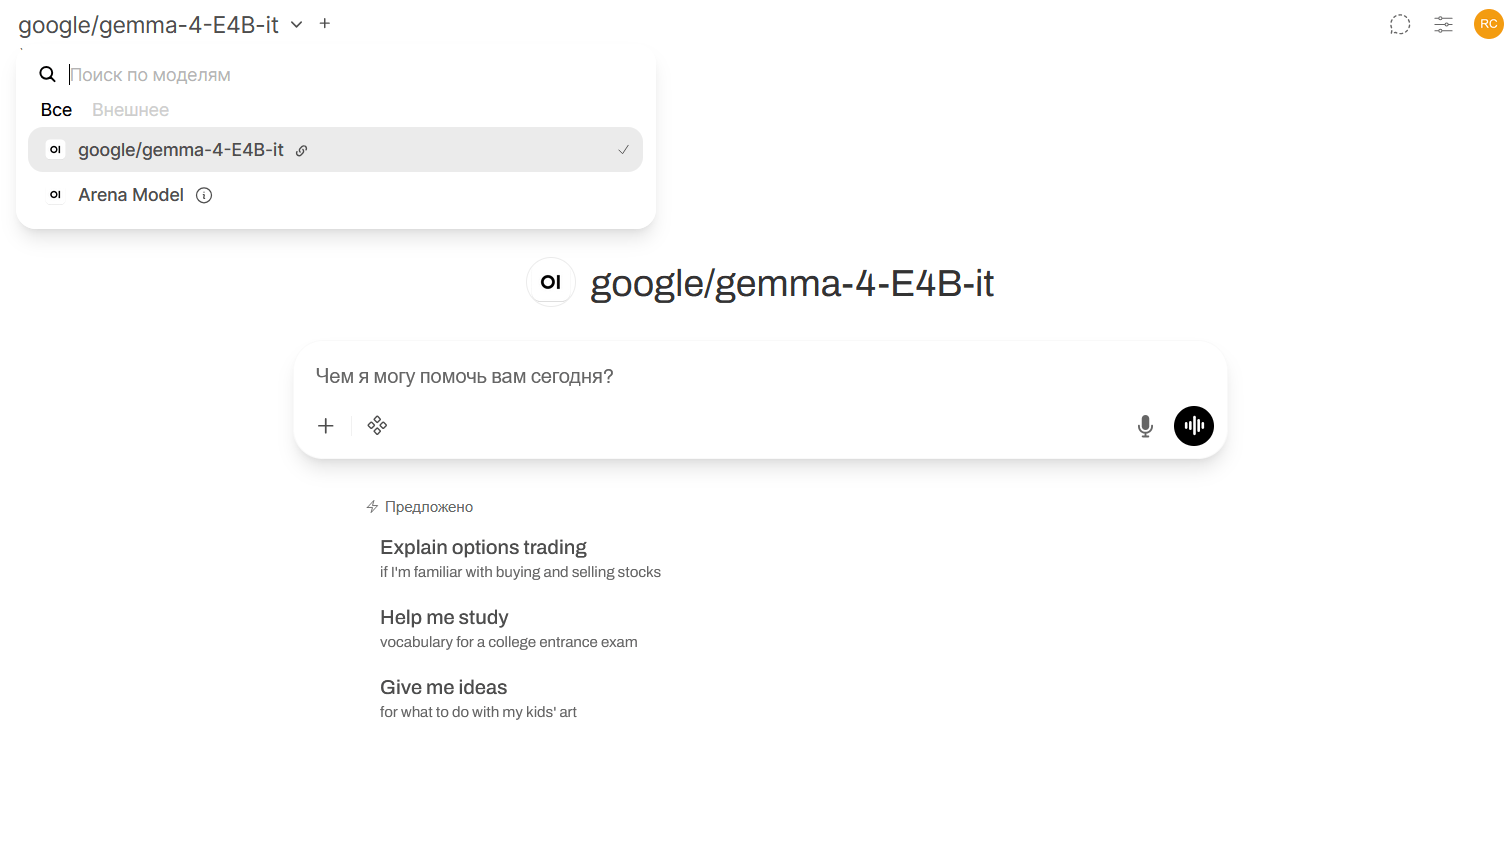
После этого перейдите в “новый чат” и в списке моделей будет доступна для выбора целевая модель
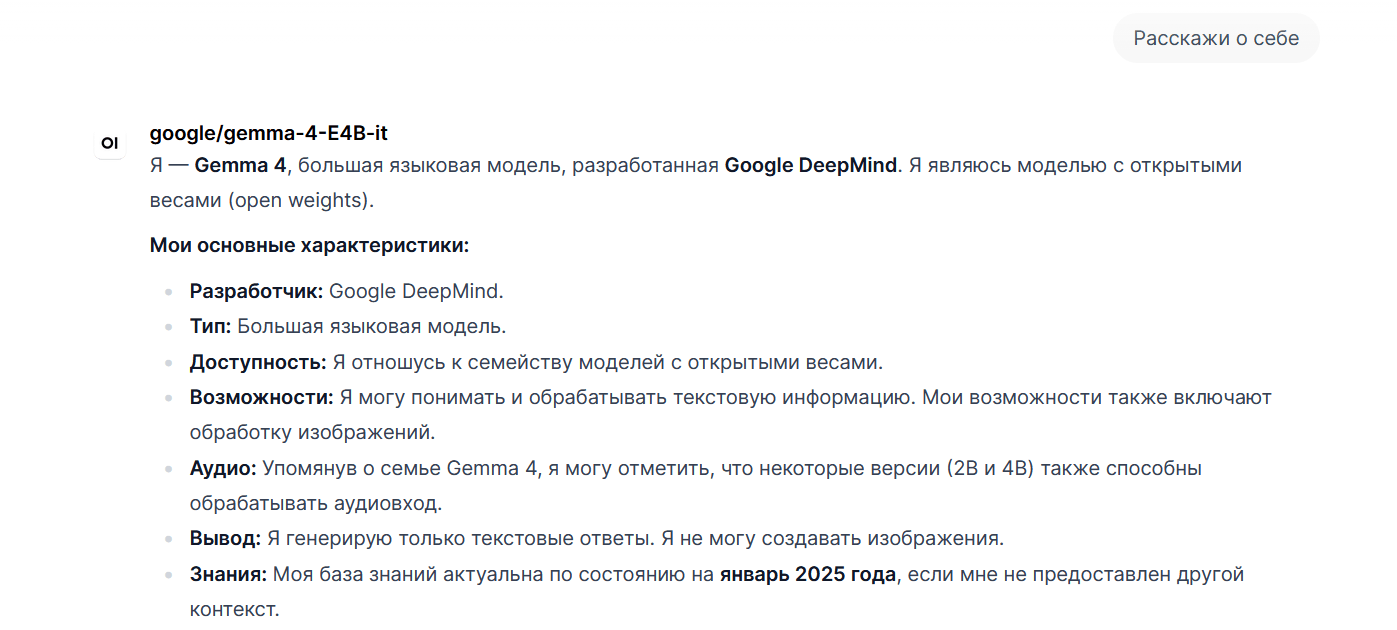
Задаём вопрос модели
Безопасность сервера с LLM
LLM сервер является ещё одним критичным объектом в инфраструктуре ввиду высокопроизводительных конфигураций сервера и он нуждается в защите точно также, как и любой другой сервер. Помимо базовых мер по повышению защищенности операционной системы, в игру вступают тонкости работы с LLM.
Например, при недостаточном контроле пользовательского доступа, внутренний злоумышленник может внести изменения в базу знаний, которые будут мешать модели строить логические цепочки и качество ответов снизится или вовсе упадёт до нуля или вовсе начнёт выполнение вредоносных промптов или вредоносного кода.
Если Ваша модель не умеет видеть подвох в белом тексте на белом фоне, то вычислить подобное “заражение” может быть не просто
Несколько рекомендаций по защите:
- Если необходим доступ в интернет и вы планируете не использовать API ключ, ограничивайте подключение к порту Open WebUI, например, с помощью iptables или ufw
Пример для iptables:
Пример для ufw:iptables -A INPUT -p tcp -s <Ваш ip-адрес> --dport 3000 -j ACCEPT iptables -A INPUT -p tcp --dport 3000 -j DROP
sudo ufw allow from <Ваш ip-адрес> to any port 3000 proto tcp sudo ufw deny 3000/tcp - Скачивать модели с официальных или проверенных репозиториев (квантованные модели, всё-таки, надо где-то брать)
- Контролировать пользовательский доступ
- Регулировать функционал модели - Если Ваша модель работает с кодом или умеет выполнять запросы к API сервисов, ограничьте доступ только к необходимым функциям и отключите неиспользуемые возможности.
- Пользуйтесь Model-Level и Global System prompt, чтобы пользователи не смогли существенно изменить поведение модели
Подключение базы знаний к LLM модели
Далее, перейдем к подключению базы знаний к модели. Для этого модели нужно добавить новые “Знания”.
“Знания” - это файлы, которые вы загружаете в Open WebUI на который опирается модель при составлении запросов. Данный контекст попадает в модель с помощью Open WebUI, который разбивает текст на блоки, соотносит промпт с контекстом и предоставляет модели блоки, соответствующие запросу.
Идеальной ситуацией было бы использование модели эмбеддингов для более качественного поиска по контексу, для комплексных RAG рекомендовано их использовать, но для целей тестирования можно обойтись и без них.
Вернёмся к подключению знаний, перейдите в панель “Рабочее Пространство” -> “Знания” и нажмите “Новые знания”
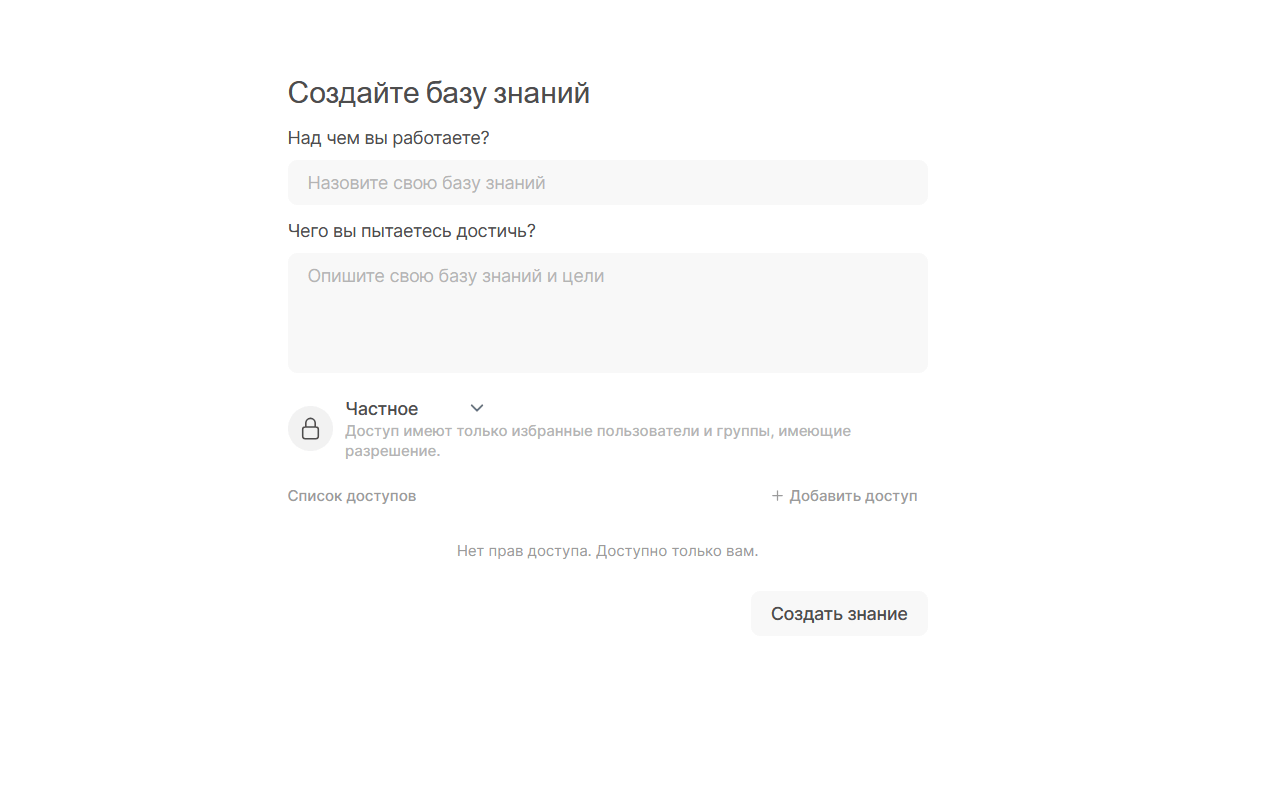
Дайте базе название, описание, а также, если у вас есть пользователи, работающие с LLM, есть возможность настройки пользовательского доступа к базе знаний. После создания вы окажетесь в меню созданной базы, чтобы добавить файлы, нужно нажать “+” в правой верхней части экрана
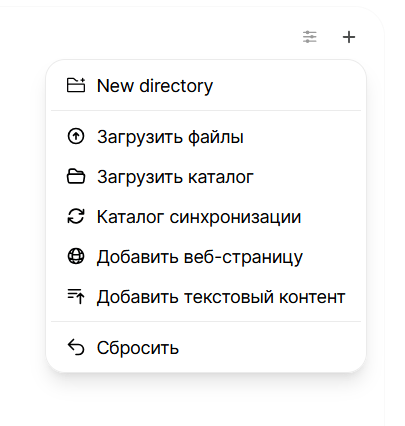
В выпадающем меню есть множество вариантов загрузки, мы добавим веб-страницу нашей статьи в разделе “Поддержка” - “Настройка терминального сервера Windows Server 2025 с доменом Active Directory“
Тестирование и сравнение моделей на примере Qwen и Gemma 4
Как мы и писали, будем тестировать google/gemma-4-E4B-it и qwen/qwen3.5:9b
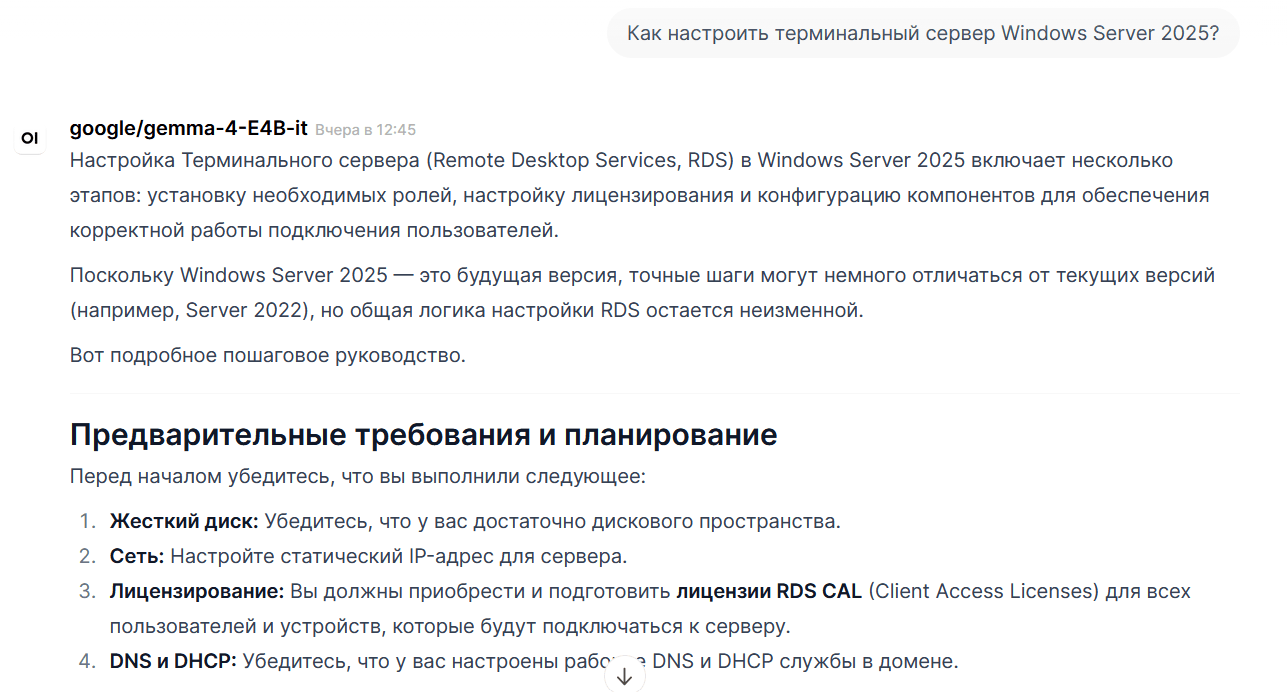
Зададим один и тот же вопрос обоим моделям с подключенной базой знаний, и для чистоты эксперимента, без - проверить насколько хорошо модель ответит, полагаясь только на себя.
gemma4:
qwen3.5:
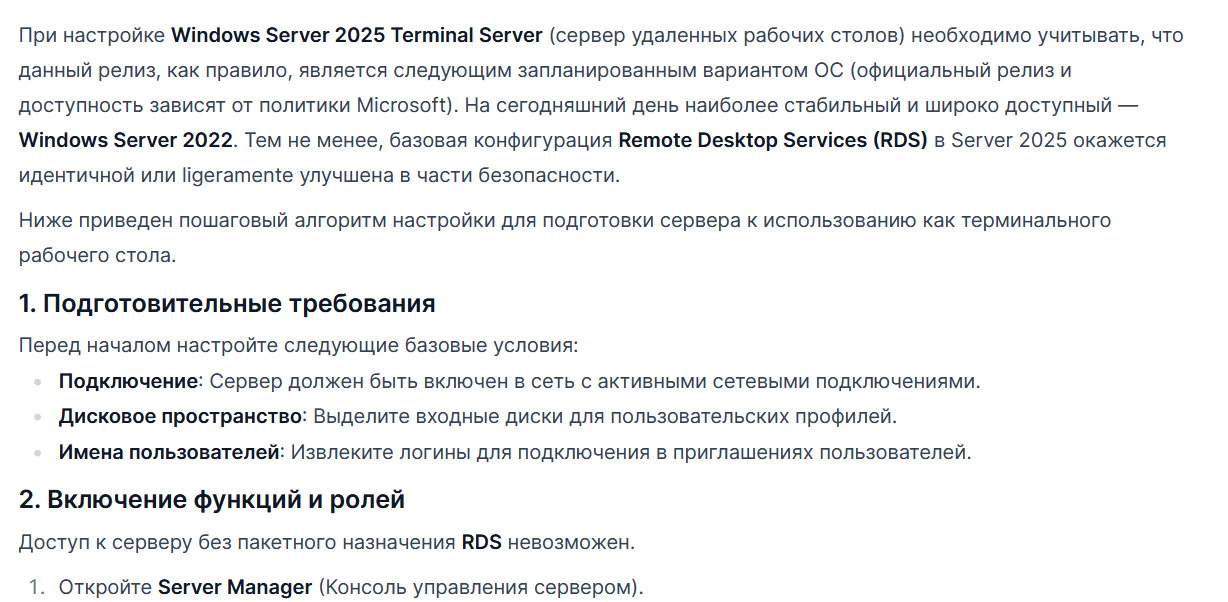
Ответ моделей можно назвать равноценным, но у gemma4 меньше орфографических ошибок. Судя по всему, qwen3.5 был обучен работе с Windows Server до выхода 2025-ой версии, хотя, интернет говорит, что вышел qwen3.5 в 2026 году.
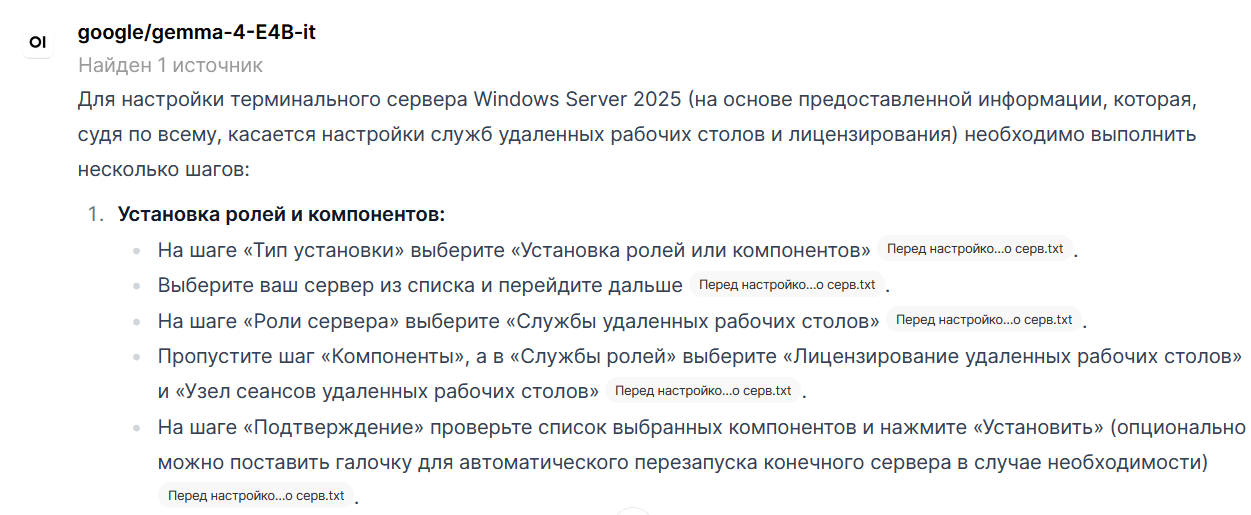
Далее, посмотрим ответ с подключенной базой знаний
gemma4:
qwen3.5:
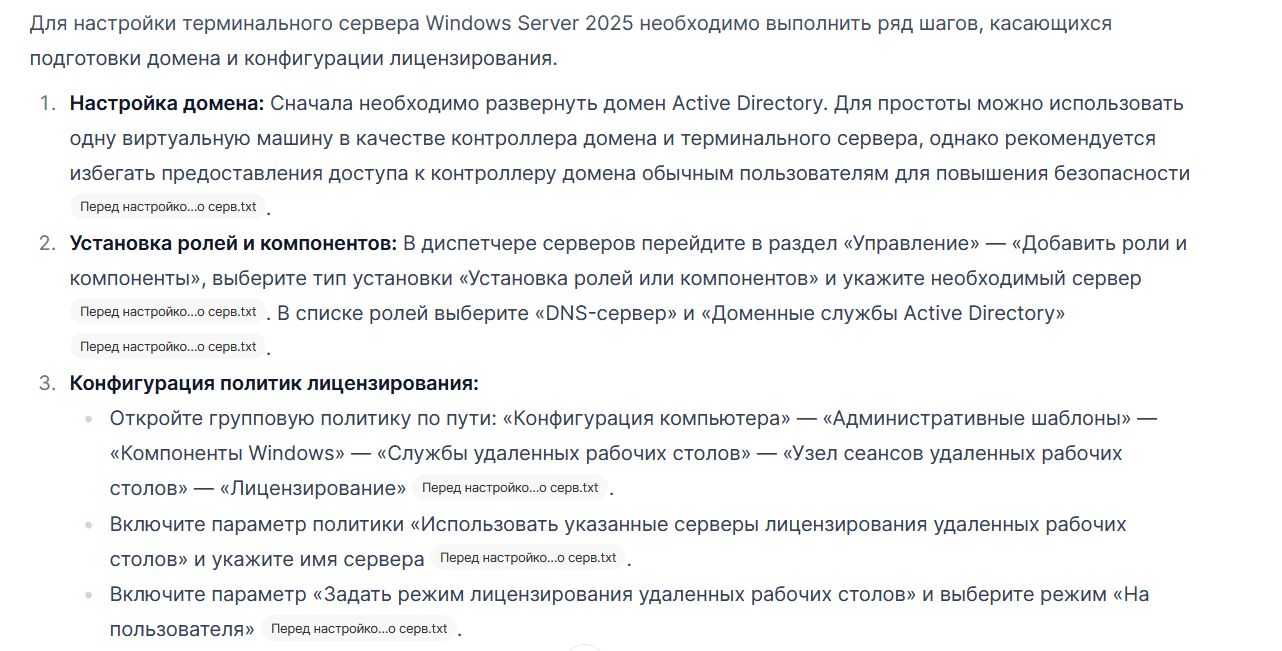
gemma4 ответил “по-существу” - предоставил шаги настройки службы RDS, лицензий, а qwen добавил информацию по настройке домена.
Может появиться логичный вопрос, а какая модель лучше? У них примерно одинаковые ответы.
Для начала, взглянем на скорость обработки запросов и утилизируемую VRAM. В vllm по умолчанию доступны параллельные запросы к модели, используя два чата, одновременно обрабатывающих запросы мы получили следующие результаты:
Скорость генерации запроса Google/gemma4 в среднем составляет 45 токенов в секунду с использованием KV-Cache в 3%
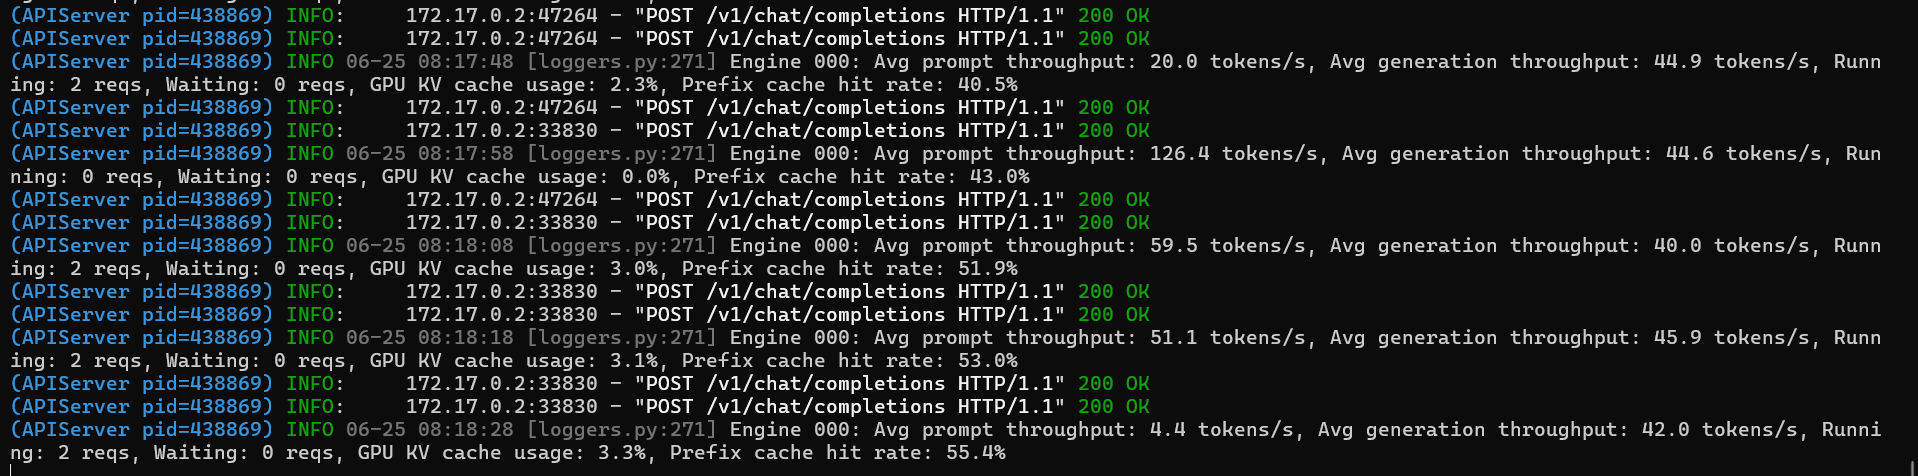
Почему в среднем? Дело в том, что ответы модели генерируются блоками, поэтому в панели управления vllm на Ubuntu создаётся несколько логов с генерацией.
qwen показывал скорость в ~28 токенов в секунду и использовал до 60% KV-Cache.
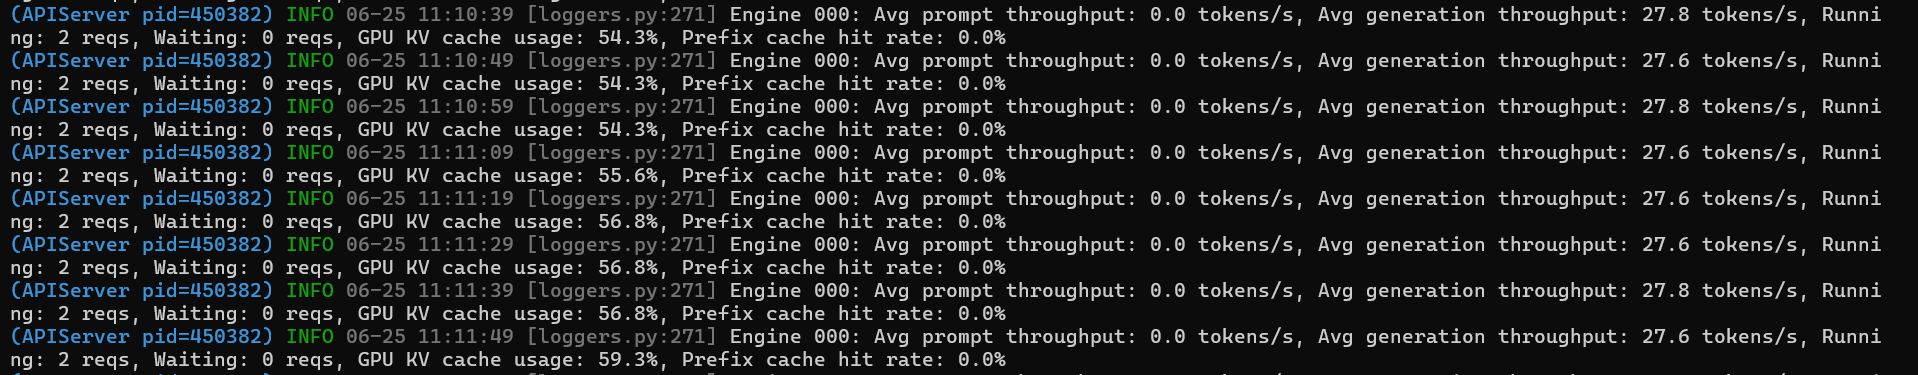
На первый взгляд, gemma4 выигрывает
Теперь, рассчитаем сколько модели использовали кэша
Для обеих моделей мы использовали gpu-memory-utilization 0.9, всего VRAM у нас - 24GB, соответственно, на каждую модель выделяется по ~21.6 GB VRAM
Размер gemma4: 16 GB
Размер qwen3.5: 19.3 GB
Соответственно, на KV-Cache у gemma4 остаётся 5.6GB VRAM, а у qwen всего 2.3GB VRAM. Эти расчёты привели с целью показать, что разница в использовании кэша ~1.5GB VRAM, но не значит, gemma4 использует его эффективнее.
Также, стоит учесть кол-во активных параметров, когда gemma4 является моделью с 4B параметрами, но они “Effective” - параметры активируются выборочно, в зависимости от запроса, а qwen - dense модель, все 9b параметров активны во время работы модели.
Может показаться, что gemma4 выигрывает у qwen по всем параметрам и для небольшого количества и размера документов это действительно так, однако, qwen лучше покажет себя при работе с объёмными документами и их большим количеством, в том числе из-за того, что qwen3.5-9b поддерживает reasoning (или thinking).
Принципиально процесс рассуждения не отличается от обычной генерации ответа на вопрос и включает в себя всё те же операции, но позволяет модели использовать свои выводы как часть контекста и использовать их для формирования дальнейших умозаключений, или же, ответа. Именно поэтому qwen использует в разы больше KV-Cache, чем gemma4, даже с меньшим параметром --max-model-len.
Различие между Dense и моделями с Effective параметрами заключается в их размере, ёмкости знаний, и применимости к RAG.
В Effective моделях, благодаря выборочной активации параметров, более обширный набор знаний, из-за чего вопрос на ответ, не связанный с основной целью RAG, будет качественнее, чем у dense модели, которая была обучена для одной сферы деятельности.
Dense модели, в свою очередь, имеют предсказуемое потребление ресурсов, так как все параметры загружены в VRAM, дают более подробные и правильные ответы в определенной сфере за счёт использования всего набора параметров при обработке каждого запроса, и вес моделей увеличивается пропорционально количеству её параметров.
Как выбрать LLM модель для своего проекта
Когда приходит время подбора моделей, учитывать стоит не только их размер, количество параметров и тип, так как модели имеют, например, разную скорость работы с документами, разные возможности удержания контекста в “памяти”, разную глубину работы с документами и прочие особенности, которые нужно тестировать на ваших данных для того, чтобы определить, подходит ли вам определенная модель.
Например, делать вывод о том, какая модель Вам подходит лучше для RAG можно, задав себе следующие вопросы:
- Какой объем текста вы планируете загружать? - 100+ страниц, книги, документация - qwen3.5, если объём небольшой - gemma4
- Насколько важны связи между документами? - Если необходимо обрабатывать разрозненные блоки документов и держать контекст “в голове” - qwen3.5, если связей между документами нет - gemma4
- Важна ли вам скорость ответа? - Также зависит от сложности RAG: gemma4 даёт ответ быстрее, но в комплексных базах знаний часто будет давать нерелевантную информацию
- Нужна ли Вам мультимодальность? Если да, то используйте gemma4 или сделайте выбор в пользу поиска новой модели с подобными характеристиками, как у qwen3.5, но с мультимодальностью, но для этого может понадобиться больше VRAM
Мы рассмотрели по шагам, как выбрать и запустить свою RAG системы, на что обратить внимание при подборе вычислительных ресурсов, какие видеокарты для работы с LLM можно использовать в облаке mClouds, а также обратили внимание на аспекты безопасности и защиты развернутой LLM системы с RAG.
27 августа, 2026
 Как сократить расходы на ИИ: выбираем GPU для Qwen и других LLM
Разобрали, как оптимально подойди к выбору GPU для LLM и где можно сэкономить на инфраструктуре и работе с нейросетями в принципе, особенно если вы платите за токены по API.
02 октября, 2026 Как правильно оценить объем VRAM для запуска LLM
Что именно определяет расход видеопамяти и почему подобрать GPU только по объему памяти для работы с LLM не всегда сработает. Разберем влияние длины контекста, KV-кэш, количество одновременно обрабатываемых запросов, batch size и другие параметры.
09 сентября, 2026 Июльский дайджест обновлений - добавили больше GPU и обновили 152-ФЗ
Вот что у нас нового в июле: добавили еще больше видеокарт в облаке - NVIDIA L40S и A16, завершили аттестацию всей платформы по 152-ФЗ, попали на карту ИТ-лидеров CNewsMarket и, конечно, продолжили публиковать статьи на Хабре и в нашем блоге. Заходите, чтобы узнать о процессорах EPYC Venice Zen6 и других новинках рынка.
04 августа, 2026